Big techs apoiam veto ao treinamento de IA: o que muda para quem tem um site
OpenAI, Google, Microsoft e Anthropic apoiam um sinal para recusar treinamento de IA. Entenda o alcance, os prazos e os limites desse acordo.
OpenAI, Google, Microsoft e Anthropic apoiam uma forma comum de sites expressarem que não querem seu conteúdo usado no treinamento de IA. O anúncio desta sexta-feira, 30 de outubro, mexe numa disputa que interessa a qualquer empresa que publica artigos, pesquisas ou materiais próprios na internet: quem decide como esse conteúdo alimenta os modelos?
Esta reportagem parte do anúncio oficial da OpenAI, do rascunho técnico citado pela empresa e da documentação dos seus robôs de coleta. A cobertura do The Verge, publicada às 20h26 UTC, registra o apoio das quatro empresas.
A ressalva aparece logo no comunicado: a iniciativa é voluntária. A OpenAI pretende implementar o sinal nos próximos meses, sem anunciar uma data exata.
O que as empresas estão apoiando?
A proposta permite registrar uma preferência sobre treinamento de IA no robots.txt, arquivo que os sites já usam para se comunicar com robôs.
O ganho prometido é publicar uma escolha que possa ser interpretada por vários fornecedores participantes, reduzindo a manutenção de regras separadas para cada um.
Segundo a OpenAI, os controles atuais continuam valendo. O novo sinal será acrescentado a eles.
Isso interessa, por exemplo, a uma editora que hoje precisa acompanhar os nomes dos robôs de diferentes empresas. Nesse exemplo hipotético, uma preferência comum diminuiria o número de regras específicas que a equipe precisa administrar, desde que os fornecedores adotem a proposta.
O anúncio ainda não demonstra que essa simplificação já esteja funcionando em todos os serviços envolvidos. É um compromisso de adoção, com implementação futura explicitada pela OpenAI.
Já virou um padrão oficial da internet?
O documento citado é um rascunho individual apresentado à IETF em 30 de outubro. A própria página do documento informa que ele não tem endosso da instituição nem posição formal no processo de padronização.
Esse detalhe muda a leitura da manchete. Existe uma proposta técnica concreta e apoio empresarial anunciado, mas o processo de discussão continua aberto.
O rascunho usa o identificador __usage_ai-training e aproveita as regras de caminhos já existentes no robots.txt.
Assim, a preferência pode variar conforme a área do site, em vez de obrigatoriamente valer para tudo.
Na definição utilizada pelo texto, treinamento envolve modificar os parâmetros aprendidos de um modelo generativo. As regras para coleta de páginas continuam independentes das preferências sobre uso do conteúdo.
O próprio documento diz que o sinal não é uma instrução de comportamento de coleta. Por isso, descrevê-lo simplesmente como um botão que impede qualquer robô de acessar um site exagera seu alcance.
Recusar treinamento tira meu site das respostas do ChatGPT?
A documentação atual da OpenAI já separa busca e treinamento. Ela permite autorizar o robô de busca enquanto se expressa uma recusa ao uso para treinamento por meio do GPTBot.
Na documentação dos crawlers, o OAI-SearchBot é responsável por ajudar a apresentar sites nas respostas de busca do ChatGPT.
O GPTBot coleta páginas que podem ser usadas no treinamento dos modelos generativos fundamentais da empresa.
A empresa explica que cada configuração é independente.
Também informa que mudanças no robots.txt podem levar aproximadamente 24 horas para se refletirem nos seus sistemas de busca.
Para uma empresa que depende de descoberta online, essa distinção importa. Uma escolha sobre treinamento e outra sobre aparecer na busca atendem a objetivos diferentes, mesmo quando envolvem as mesmas páginas.
Por que o acordo continua polêmico?
Porque expressar uma preferência e resolver a disputa sobre direitos de conteúdo são coisas com alcances diferentes. No mesmo dia, a OpenAI publicou uma defesa do fair use aplicado ao treinamento de IA, reunindo argumentos de apoiadores apresentados à Justiça dos Estados Unidos.
A publicação trata do processo movido pelo The New York Times e sustenta a posição da empresa nessa disputa. Esses argumentos representam uma defesa apresentada no debate, e não uma decisão judicial anunciada no comunicado.
Os dois textos mostram a tensão: fornecedores propõem facilitar a comunicação das escolhas dos sites enquanto continuam defendendo seu entendimento sobre o uso de conteúdo no treinamento. O sinal comum, por si só, não anuncia remuneração aos autores nem encerra essa discussão.
Minha leitura é que a iniciativa só poderá ser avaliada pelo que os fornecedores efetivamente implementarem. O anúncio fornece uma direção; o calendário e os detalhes de adoção vão determinar o alcance real para quem publica.
O que isso muda para quem usa IA no negócio?
A notícia coloca três decisões na mesa de quem mantém um site: como quer aparecer nas buscas, qual preferência deseja expressar sobre treinamento e quais controles os fornecedores já respeitam. O anúncio da OpenAI mantém os mecanismos atuais enquanto prepara o novo sinal.
Uma empresa com um acervo de pesquisas próprias, por exemplo, pode querer continuar sendo encontrada por clientes sem tratar todo uso desse material da mesma forma. É um cenário hipotético que ajuda a explicar por que a separação entre busca e treinamento merece atenção.
Para conectar esse tipo de decisão ao uso de IA em marketing, vendas, atendimento e análise, o ibe.IA oferece a Formação em IA para Negócios.
E para acompanhar as próximas mudanças com esse recorte prático, o perfil do instituto é @ibe.ia no Instagram.
Fonte
- OpenAI: Making it easier for websites to express AI training preferences, 30 de outubro de 2026.
- IETF Datatracker: Machine-Readable Training Preference Signal, rascunho individual 00, 30 de outubro de 2026.
- OpenAI: Overview of OpenAI Crawlers.
- OpenAI: Fair use benefits everyone, 30 de outubro de 2026.
- The Verge: The biggest names in AI are backing a new way to opt out of scraping, 30 de outubro de 2026.
Materiais Gratuitos
Crie um SaaS que paga suas contas
Aula gratuita: aprenda a criar aplicativos web e mobile com Vibe Coding e IA, sem saber programar. Nossos alunos publicam o primeiro app em menos de 7 dias.
Assistir Aula Gratuita →Fature R$12k/mês como Gestor de IA
Aula gratuita: descubra a profissão do Gestor de IA. Aprenda a criar agentes e automações com n8n e fature R$12 mil/mês trabalhando de casa, sem programar.
Assistir Aula Gratuita →3 formações em 1
Tudo que você precisa para dominar IA
Vibe Coding + Agentes IA + IA para Negócios em um único pacote.
Formação em Vibe Coding
Aprenda a criar Apps, SaaS e plataformas completas com Vibe Coding e IA.
-
 Claude Code
-
 Cursor
-
 Antigravity
-
 Lovable
-
 Supabase
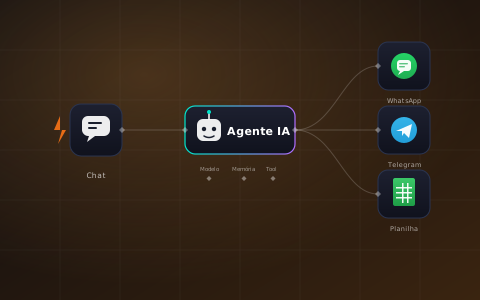
Formação em Agentes IA e Automações
Domine Agentes IA e Automações para atender clientes no WhatsApp, otimizar processos e eliminar trabalho repetitivo.
-
 n8n
-
 SquadOS
Formação em IA para Negócios
Implemente IA em todos os departamentos da empresa: conteúdo, marketing, imagens, vídeos, gestão e análise de dados.
- Claude Cowork
- Claude Code
-
 ChatGPT
-
 Magnific
-
 Heygen